
Исследователи Корейского института передовых технологий (KAIST) представили новую систему искусственного интеллекта DLLM-VSR, способную преобразовывать движения губ человека в текст. Технология работает без использования микрофона и анализирует исключительно видеозапись лица. По результатам испытаний разработка превзошла другие модели, обученные на аналогичном наборе данных.
Главная особенность системы заключается в необычном подходе к распознаванию речи. Вместо того чтобы последовательно определять каждое слово, нейросеть сначала выделяет наиболее понятные фрагменты предложения, а затем восстанавливает пропущенные части с учетом контекста.
Искусственный интеллект научили понимать сложные фразы
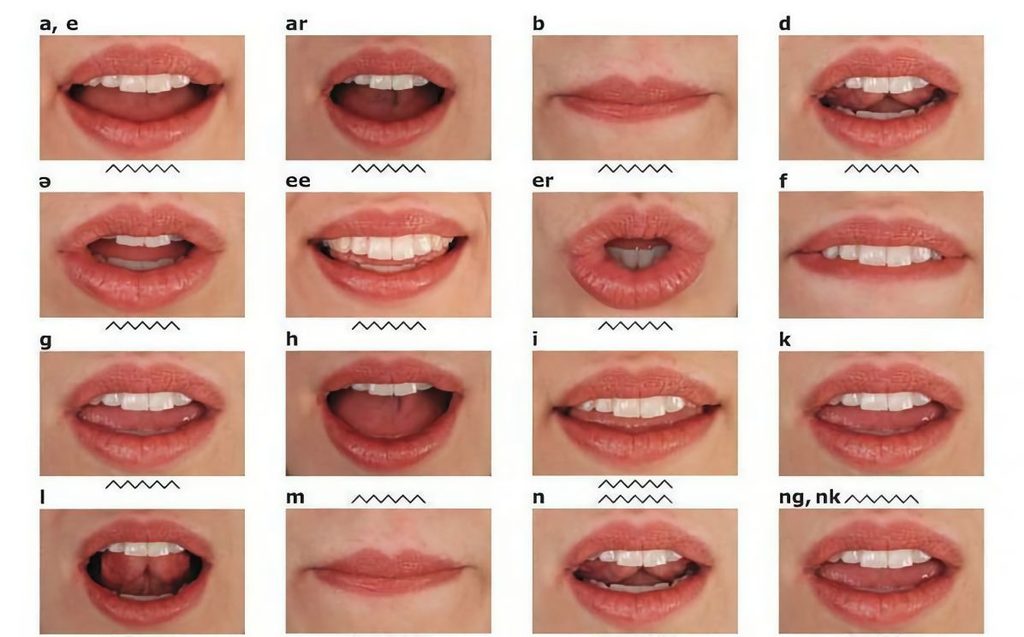
Чтение по губам остаётся сложной задачей даже для современных нейронных сетей. Причина заключается в том, что разные звуки могут сопровождаться практически одинаковыми движениями губ. Из-за этого системы нередко путают слова, особенно если у них нет доступа к звуковой дорожке.
Добавьте GSMinfo в источники в Google News Чтобы видеть наши публикации в своей ленте новостейРазработчики DLLM-VSR использовали метод, позволяющий анализировать контекст одновременно с начала и конца фразы. Благодаря этому алгоритм может более точно определять слова, которые невозможно однозначно распознать только по движениям рта.

Для обучения модели ученые использовали 433 часа видеозаписей с текстовыми расшифровками. В ходе тестирования система продемонстрировала уровень ошибок распознавания слов в 19,4%. Этот показатель учитывает неправильно определённые, пропущенные и лишние слова, поэтому не означает, что нейросеть правильно расшифровывает 80,6% всех разговоров.
Где будет применяться новая технология
Одним из перспективных направлений применения DLLM-VSR является создание вспомогательных устройств для людей с нарушениями слуха. Система потенциально позволит преобразовывать беззвучную речь собеседника в текст в ситуациях, когда обычные средства коммуникации не работают.
Кроме того, эта технология может оказаться полезной на промышленных предприятиях с высоким уровнем шума, где голосовые команды сложно распознать даже с помощью современных микрофонов.
Однако до практического внедрения ещё далеко. Нынешняя версия DLLM-VSR требует значительных вычислительных ресурсов и пока не подходит для полноценной работы в реальном времени.
Следующей задачей исследователей станет оптимизация алгоритма для использования в компактных устройствах, в частности в носимой электронике и робототехнических системах.