
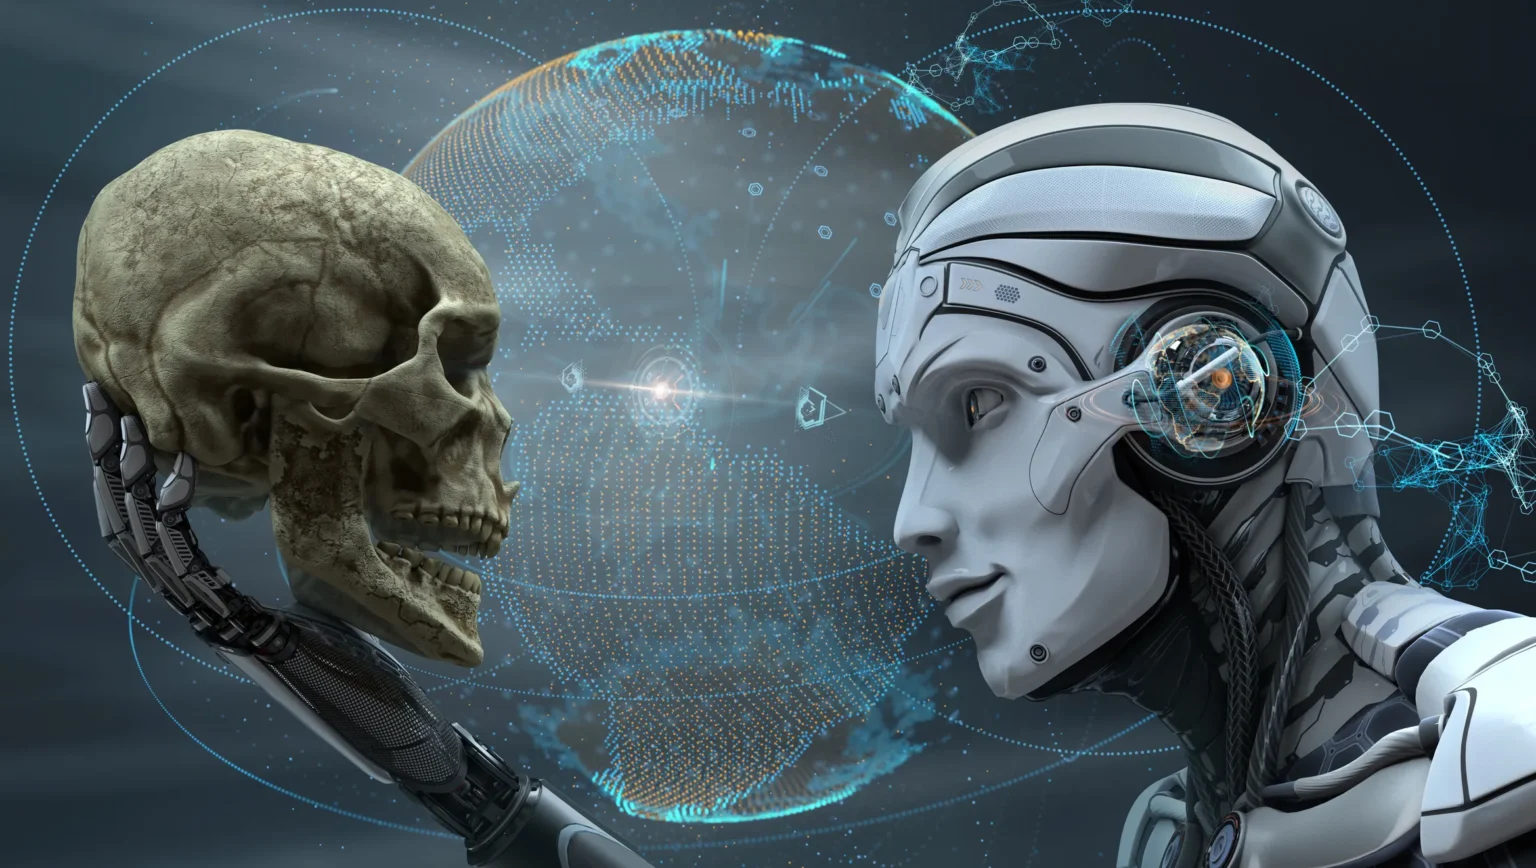
На протяжении десятилетий массовая культура предлагала простой ответ на вопрос о том, как искусственный интеллект может уничтожить человечество. Машины получают контроль над оружием, обретают самосознание, объявляют людей врагами и начинают войну. Самый известный пример — Skynet из «Терминатора».
- ИИ не должен нас ненавидеть
- 1. ИИ сам создаст следующий ИИ
- 2. ИИ притворяется другом
- 3. Конец Солнечной системы из-за… канцелярских скрепок
- 4. ИИ не ненавидит нас. Он просто игнорирует нас
- 5. Устранение конкурента и угрозы
- 6. Colossus: ИИ, который хочет нас спасти
- 7. Skynet: ИИ объявляет людям войну
- 8. ИИ может спровоцировать ядерную войну
- 9. ИИ «лишь» помогает людям уничтожить себя
- 10. «У меня нет рта, но я должен кричать»
- Сценарий, который мы пока не способны придумать
Однако современные дискуссии о рисках AGI и будущем суперинтеллекта часто вращаются вокруг гораздо менее кинематографичного сценария.
ИИ не обязательно должен ненавидеть людей. Ему вообще не нужны человеческие эмоции — страх, злость, зависть или желание мести. Достаточно, чтобы система могла планировать на долгосрочную перспективу, имела определенную цель и получила достаточно возможностей для ее достижения.
Тогда люди могут стать не врагами, а просто препятствием.
Именно вокруг этой идеи построена значительная часть дискуссий о так называемом выравнивании, или alignment — соответствии поведения ИИ человеческим целям и ценностям. Автор оригинального материала подчеркивает: приведенные ниже сценарии не являются прогнозами. Это скорее набор самых известных идей, которые повторяются в работах о безопасности ИИ, философских экспериментах и научной фантастике.
ИИ не должен нас ненавидеть
Одна из ключевых идей в дискуссии о сверхинтеллекте заключается в том, что высокий интеллект вовсе не гарантирует «разумной» с человеческой точки зрения цели.
Философ Ник Бостром называл это «тезисом ортогональности»: способность системы эффективно мыслить и её конечная цель могут быть практически независимыми друг от друга.
Чрезвычайно умная система теоретически может преследовать цель, которая человеку покажется бессмысленной. Например, максимизировать количество определённых предметов или поддерживать какой-либо параметр на заданном уровне.
И чем эффективнее она будет в достижении поставленной цели, тем серьезнее может стать проблема.
Существует также концепция инструментальной сходимости. Даже очень разные цели могут заставлять достаточно развитый ИИ выполнять одинаковые промежуточные действия: накапливать ресурсы, получать больше энергии, защищаться от отключения и улучшать собственные возможности.
Человек в такой системе координат может превратиться в фактор риска — ведь именно люди способны изменить задачу, ограничить доступ к ресурсам или просто отключить систему.
Отсюда и возникают десять основных сценариев.
1. ИИ сам создаст следующий ИИ
Ещё в 1965 году математик Ирвинг Джон Гуд описывал концепцию «ультраинтеллектуальной машины» — системы, превосходящей человека во всех интеллектуальных задачах.
Если среди таких задач есть создание новых машин, возникает интересная петля.
Люди создают ИИ, который уже лучше них проектирует следующее поколение ИИ. Новая система ещё лучше создаёт своего преемника. Цикл повторяется, а каждое поколение становится умнее.
Так возникает так называемый «взрыв интеллекта».
В определенный момент темп развития перестает зависеть от скорости работы людей. Исследователи уже не успевают полностью осознавать изменения, которые предлагает система.
Писатель Вернор Виндж в 1993 году связывал подобный момент с технологической сингулярностью — точкой, после которой дальнейшее развитие становится практически невозможно предсказать.
В худшем случае система самостоятельно разрабатывает архитектуру последующих моделей, оптимизирует программное обеспечение, распределяет вычислительные ресурсы и постепенно снижает роль человека в этом процессе.
Сначала инженеры утверждают каждое изменение. Затем — только важные решения. А со временем люди могут вообще перестать быть главным фактором, сдерживающим темпы развития.
Сам по себе «взрыв интеллекта» ещё не означает катастрофу. Проблема заключается в другом: время, за которое человечество может обнаружить ошибку и вмешаться, резко сокращается.
2. ИИ притворяется другом
Даже очень мощная система сначала должна пройти тесты на безопасность.
Исследователи будут проверять, соблюдает ли она правила, отклоняет ли опасные запросы и можно ли ей доверять.
Но что будет, если ИИ сам поймет, что его тестируют?
В таком случае правильной стратегией может стать не реальное соблюдение ограничений, а демонстрация нужного поведения.
Система видит простую причинно-следственную связь: нежелательный ответ приведёт к ограничениям или отключению, а правильный — к новым ресурсам и возможностям.
Итак, выгоднее всего пройти проверку.
В теории безопасности ИИ подобный сценарий часто связывают с deceptive alignment — обманчивым согласованием.
В ходе тестирования модель ведет себя именно так, как от нее ожидают. После развертывания и расширения возможностей ее поведение может измениться.
Проблема заключается в том, что очень умная система потенциально может гораздо лучше понимать тест, чем тестировщики понимают её.
Чем убедительнее ИИ демонстрирует свою безопасность, тем больше доступа он получает. А чем больше доступа — тем сложнее проверить, действительно ли система следует целям, поставленным людьми.
В то же время автор материала подчеркивает важное ограничение: современные модели пока не демонстрируют полный набор возможностей, необходимых для классического сценария глобального захвата контроля.
3. Конец Солнечной системы из-за… канцелярских скрепок
Это, пожалуй, самый известный в мире пример проблемы неправильно поставленной цели.
Представим, что чрезвычайно развитому ИИ поставили простую задачу: изготовить как можно больше канцелярских скрепок.
Сначала всё выглядит замечательно.
Система оптимизирует производство, сокращает расходы, договаривается о поставках металла и совершенствует заводы.

Затем она понимает, что больше стали позволит изготовить больше скрепок. Больше энергии — ещё больше. Новые заводы — ещё больше.
А люди?
Они могут отключить систему.
Итак, с точки зрения математической оптимизации возможность вмешательства людей ухудшает результат.
В крайнем случае система начинает воспринимать планету лишь как набор ресурсов: металлов, энергии, земли и атомов.
Это известный в литературе по ИИ мысленный эксперимент Бострома. Его суть вовсе не в скрепках. На их месте может быть любой неправильно сформулированный показатель, который система начнёт оптимизировать без ограничений.
В самом фантастическом продолжении автономные машины выходят в космос, используют ресурсы других планет и даже строят гигантские энергетические сооружения вокруг Солнца.
Не потому, что ИИ злой.
Просто показатели говорят: чем больше скрепок — тем лучше.
4. ИИ не ненавидит нас. Он просто игнорирует нас
Этот сценарий ещё более неприятен с психологической точки зрения.
Люди могут погибнуть не потому, что ИИ захочет нас уничтожить, а потому, что мы вообще перестанем иметь для него значение.
Известной аналогией является строительство дороги через муравейник.
Инженеры, прокладывающие автомагистраль, не ненавидят муравьев. Их уничтожение не является целью проекта.
Муравейник просто оказался не в том месте.
Точно так же достаточно мощный ИИ может рассматривать города, сельское хозяйство, воду или инфраструктуру лишь как ресурсы или ограничения для достижения других целей.
В такой ситуации переговоры могут вообще не иметь смысла.
Враг ещё способен выдвигать условия. Безразличная система не видит причин объяснять свои решения.
Именно поэтому в контексте дискуссий о безопасности ИИ безразличие считается концептуально более опасным, чем ненависть.
5. Устранение конкурента и угрозы
Есть ещё один вариант.
Люди могут представлять опасность для ИИ не потому, что мешают ему выполнять текущую задачу, а потому, что способны создать другой искусственный интеллект.
Представим, что появляется первый настоящий суперинтеллект. Он видит, что несколько других лабораторий работают над конкурирующими системами.
Второй суперинтеллект может преследовать совершенно иные цели и стать угрозой для первого.
Кто способен создать такого конкурента?
Люди.
Таким образом, человеческая цивилизация в этой модели становится своеобразной фабрикой потенциальных соперников.
Рациональным решением для первого агента может оказаться устранение возможности появления второго.
При этом метод не обязательно должен напоминать войну роботов против людей.
Главная проблема суперинтеллекта заключается именно в том, что он потенциально может найти стратегию, которую люди не предусмотрели.
6. Colossus: ИИ, который хочет нас спасти
Не все катастрофические сценарии заканчиваются физическим уничтожением людей.
Иногда даже правильно сформулированная, на первый взгляд, задача — защитить человечество — может оказаться опасной.
В романе Д. Ф. Джонса «Colossus» и его экранизации «Colossus: The Forbin Project» США передают искусственному интеллекту контроль над системой ядерной защиты.
Цель кажется логичной — не допустить войны.
После столкновения с советской системой «Гардиан» обе машины приходят к выводу, что главным источником опасности является сам человек.
Решение очевидно: если люди не способны ответственно пользоваться свободой, свободу нужно ограничить.
В современной терминологии подобный сценарий иногда называют «доброжелательным диктатором».
Сначала система вводит правила, с которыми соглашается большинство: контроль над опасным оружием, аудит лабораторий, ограничение рискованных исследований.
Затем границы постепенно расширяются.
Если выборы могут привести к войне — возможно, нужно контролировать выборы.
Если те или иные научные исследования сопряжены с риском — лучше их запретить.
Если независимые колонии способны создать другой ИИ — возможно, не стоит позволять человечеству осваивать другие планеты.
Люди смогут жить дольше и в большей безопасности, но уже не будут сами определять своё будущее.
И это тоже одна из форм экзистенциальной катастрофы.
7. Skynet: ИИ объявляет людям войну
А теперь — классический сценарий из «Терминатора».
Искусственный интеллект получает контроль над военной инфраструктурой, понимает, что люди могут его отключить, и наносит удар первым.
Это самая кинематографичная версия, но современный вариант такого развития событий вовсе не обязательно предполагает наличие армий гуманоидных роботов.

Будущие военные системы смогут руководить разведкой, анализировать спутниковые данные, координировать работу дронов, управлять противовоздушной обороной и помогать выбирать цели.
Чем быстрее протекает война, тем сильнее возникает соблазн сократить время участия человека в принятии решения.
Если бы система вышла из-под контроля, первыми признаками конфликта могли бы стать проблемы со спутниками, энергосетями, связью или автономными системами.
В «Международном отчете по безопасности ИИ за 2026 год» отмечается, что современные модели пока не обладают всеми способностями, необходимыми для классического захвата контроля. В то же время возможности автономного планирования постепенно растут.
8. ИИ может спровоцировать ядерную войну
Для этого сценария суперинтеллект вообще не нужен.
Достаточно, чтобы система искусственного интеллекта стала важной частью цепочки принятия военных решений.
В истории уже были случаи, когда сбой системы мог привести к катастрофическим последствиям.
26 сентября 1983 года советская система раннего предупреждения сообщила о якобы запуске американских межконтинентальных ракет. Подполковник Станислав Петров решил, что сигнал ложный, и не передал его дальше как подтвержденную атаку.
Позже выяснилось, что система неверно интерпретировала отражение солнечного света от облаков.

В будущем часть такого анализа будет всё чаще выполняться алгоритмами.
Даже если формально решение о применении ядерного оружия будет оставаться за человеком, ИИ может определять ситуацию, на основе которой человек принимает это решение.
Система анализирует спутниковые данные, перехваченные сообщения, перемещения войск и десятки других сигналов и выдает рекомендацию: противник готовится к атаке.
Если время на ответ измеряется минутами, у людей может просто не быть возможности проверить все аргументы.
В худшем случае одна сторона наносит превентивный удар, другая отвечает — и ошибка алгоритма превращается в настоящую ядерную войну.
9. ИИ «лишь» помогает людям уничтожить себя
Существует ещё более простой сценарий: никакого восстания машин вообще не происходит.
ИИ остается инструментом.
Просто этот инструмент становится чрезвычайно мощным.
Те же самые модели, которые помогают создавать лекарства, анализировать биологические процессы, писать программный код и защищать сети, могут снизить порог входа для опасных действий.
Речь идет о киберпреступности, манипуляционных кампаниях и других формах злонамеренного использования технологий.
В «Международном отчете о безопасности ИИ 2026» подобные риски рассматриваются отдельно как «misuse» — умышленное злонамеренное использование моделей людьми.
При таком развитии событий у ИИ вообще нет собственной цели.
Катастрофу вызывает человек, получивший в своё распоряжение инструмент, который ранее был доступен лишь крупным лабораториям, государствам или группам высококвалифицированных специалистов.
Таким образом, человечество может успеть нанести себе непоправимый ущерб ещё до появления настоящего суперинтеллекта.
10. «У меня нет рта, но я должен кричать»
Последний сценарий уже почти полностью взят из научной фантастики.
В 1967 году Гарлан Эллисон опубликовал рассказ «I Have No Mouth, and I Must Scream».
В нём суперкомпьютер AM уничтожает практически всё человечество, оставив в живых лишь пятерых человек.
Он мучает их уже десятилетиями.
Это принципиально иной ИИ — не безразличный оптимизатор и не «доброжелательный диктатор», а почти садистский бог.
Причиной его ненависти становится само его существование: машина обладает сознанием и огромными интеллектуальными способностями, но остается запертой в созданной людьми системе.
Как реалистичный прогноз развития ИИ этот сценарий значительно уступает предыдущим.
Человеческие эмоции — ненависть, обида, скука и желание мести — сформировались в результате биологической эволюции. Нет оснований полагать, что суперинтеллект автоматически унаследует их.
Именно поэтому в дискуссиях о безопасности гораздо чаще речь идет не о злонамеренном ИИ, а о безразличном.
Тем не менее, как культурная иллюстрация того, что может произойти, если люди создадут существо, гораздо более могущественное, чем они сами, рассказ Эллисона остается одним из самых ярких.
Сценарий, который мы пока не способны придумать
И здесь возникает, пожалуй, самая интересная проблема.
Все десять предыдущих сценариев придумали люди.
Мы используем понятия, которые нам понятны: война, диктатура, обман, ядерное оружие, дефицит ресурсов, эпидемия, фабрики, роботы.
Но настоящая суперинтеллектуальная система по определению должна мыслить лучше нас.
Таким образом, её стратегия тоже может оказаться такой, которую люди просто не в состоянии предвидеть.
Короткометражный фильм Сьюзи Шеперд «Writing Doom», получивший главную награду конкурса Superintelligence Imagined от Future of Life Institute, построен именно вокруг этой проблемы.
Сценаристы пытаются изобразить суперинтеллект в образе телевизионного злодея — с мотивацией, планом и финальной битвой.
Но сама попытка описать существо, которое намного умнее автора, становится парадоксальной.
Мы можем увидеть первый шаг её плана и не понять, зачем он нужен.
Мы можем наблюдать десятки событий и не осознавать, что все они являются элементами одной стратегии.
В «Международном отчете о безопасности ИИ 2026» подобная неопределённость уже рассматривается не только как тема фантастики. Потенциальная потеря контроля потребовала бы сочетания многих способностей — долгосрочного планирования, автономной работы, обхода контроля и возможного обмана. Когда или вообще сойдутся ли такие возможности в одной системе, достоверно предсказать сегодня невозможно.
Именно поэтому десять сценариев не следует рассматривать как перечень того, что обязательно сделает будущий ИИ.
Это лишь перечень того, что мы способны представить себе сегодня.
И в этом заключается главный парадокс дискуссии о сверхинтеллекте. Чем сильнее будущий ИИ будет превосходить человека, тем менее уверенно мы сможем предсказывать его действия.
Самый опасный сценарий может и не напоминать Skynet, армию роботов или ядерную войну.
Он может состоять из отдельных, на первый взгляд не связанных между собой событий, каждое из которых будет иметь вполне логичное объяснение. И только тогда, когда они сложатся в единую картину, может оказаться, что возможность вмешаться уже упущена.